
Android 8.0-এ থ্রুপুট ও লেটেন্সির জন্য বাইন্ডার ও hwbinder পারফর্ম্যান্স টেস্ট অন্তর্ভুক্ত। পারসেপ্টিবল পারফর্ম্যান্স সংক্রান্ত সমস্যা শনাক্ত করার জন্য অনেক পরিস্থিতি থাকলেও, এই ধরনের পরিস্থিতি রান করাতে অনেক সময় লাগতে পারে এবং সিস্টেম ইন্টিগ্রেট না হওয়া পর্যন্ত ফলাফল উপলভ্য থাকে না। প্রদত্ত পারফর্ম্যান্স টেস্ট ব্যবহার করলে, ডেভেলপমেন্টের সময় টেস্ট করা, গুরুতর সমস্যা আগে শনাক্ত করা এবং ব্যবহারকারীর অভিজ্ঞতা উন্নত করা সহজ হয়।
পারফর্ম্যান্স টেস্টে নিম্নলিখিত চারটি বিভাগ অন্তর্ভুক্ত থাকে:
- বাইন্ডার থ্রুপুট (এতে উপলভ্য
system/libhwbinder/vts/performance/Benchmark_binder.cpp) - বাইন্ডার লেটেন্সি (
frameworks/native/libs/binder/tests/schd-dbg.cpp-এ উপলভ্য) - hwbinder থ্রুপুট (এতে উপলভ্য
system/libhwbinder/vts/performance/Benchmark.cpp) - hwbinder লেটেন্সি (
system/libhwbinder/vts/performance/Latency.cpp-এ উপলভ্য)
বাইন্ডার ও hwbinder সম্পর্কে
Binder ও hwbinder হল Android ইন্টার-প্রসেস কমিউনিকেশন (IPC) ইনফ্রাস্ট্রাকচার যা একই Linux ড্রাইভার শেয়ার করে, কিন্তু নিম্নলিখিত গুণগত পার্থক্য আছে:
| আসপেক্ট | বাইন্ডার | hwbinder |
|---|---|---|
| উদ্দেশ্য | ফ্রেমওয়ার্কের জন্য সাধারণ উদ্দেশ্যমূলক IPC স্কিম প্রদান করা | হার্ডওয়্যারের সাথে যোগাযোগ করা |
| প্রপার্টি | Android ফ্রেমওয়ার্ক ব্যবহারের জন্য অপ্টিমাইজ করা হয়েছে | ন্যূনতম ওভারহেড লো লেটেন্সি |
| ফোরগ্রাউন্ড/ব্যাকগ্রাউন্ডের জন্য শিডিউলিং নীতি পরিবর্তন করা | হ্যাঁ | না |
| আর্গুমেন্ট পাস করা | পার্সেল অবজেক্টের মাধ্যমে সমর্থিত সিরিয়ালাইজেশন ব্যবহার করে | পার্সেল সিরিয়ালাইজেশনের জন্য প্রয়োজনীয় ডেটা কপি করার ওভারহেড এড়াতে স্ক্যাটার বাফার ব্যবহার করে |
| অগ্রাধিকার ইনহেরিটেন্স | না | হ্যাঁ |
বাইন্ডার ও hwbinder প্রসেস
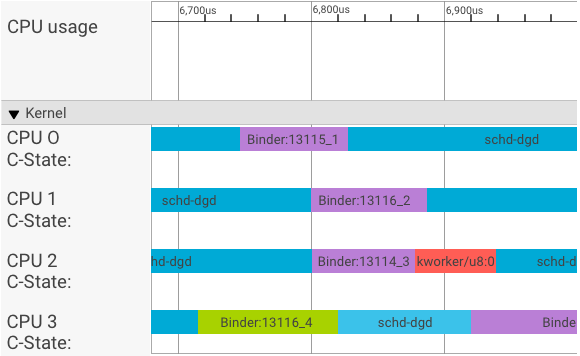
একটি সিস্ট্রেস ভিজুয়ালাইজার নিম্নলিখিতভাবে ট্রানজ্যাকশন দেখায়:
উপরের উদাহরণে:
- চারটি (৪) schd-dbg প্রসেস হল ক্লায়েন্ট প্রসেস।
- চারটি (৪) বাইন্ডার প্রসেস হল সার্ভার প্রসেস (নাম Binder দিয়ে শুরু হয় এবং ক্রমিক সংখ্যা দিয়ে শেষ হয়)।
- ক্লায়েন্ট প্রসেস সবসময় সার্ভার প্রসেসের সাথে পেয়ার করা থাকে, যা ক্লায়েন্টের জন্য নির্ধারিত।
- কার্নেল সব ক্লায়েন্ট-সার্ভার প্রসেস পেয়ারকে স্বাধীনভাবে একই সময়ে শিডিউল করে।
CPU ১-এ, OS কার্নেল অনুরোধ ইস্যু করার জন্য ক্লায়েন্টকে এক্সিকিউট করে। তারপরে, এটি সম্ভব হলেই একই CPU ব্যবহার করে সার্ভার প্রসেসকে জাগিয়ে তোলে, অনুরোধ হ্যান্ডেল করে এবং অনুরোধ সম্পূর্ণ হয়ে গেলে কন্টেক্সট সুইচ করে।
থ্রুপুট বনাম লেটেন্সি
একটি নিখুঁত ট্রানজ্যাকশনে, যেখানে ক্লায়েন্ট এবং সার্ভার প্রসেস নির্বিঘ্নে সুইচ করে, থ্রুপুট এবং লেটেন্সি টেস্ট যথেষ্ট আলাদা মেসেজ তৈরি করে না। তবে, OS কার্নেল যখন হার্ডওয়্যার থেকে আসা ইন্টারাপ্ট রিকোয়েস্ট (IRQ) হ্যান্ডেল করে, লকের জন্য অপেক্ষা করে অথবা কোনও মেসেজ সাথে সাথে হ্যান্ডেল না করার সিদ্ধান্ত নেয়, তখন লেটেন্সি বাবল তৈরি হতে পারে।

থ্রুপুট টেস্ট বিভিন্ন পেলোড সাইজ সহ প্রচুর সংখ্যক ট্রানজ্যাকশন জেনারেট করে, যা নিয়মিত ট্রানজ্যাকশন সময়ের (সবচেয়ে ভালো পরিস্থিতিতে) এবং বাইন্ডার অর্জন করতে পারে এমন সর্বাধিক থ্রুপুটের একটি ভালো অনুমান প্রদান করে।
অন্যদিকে, লেটেন্সি টেস্টে, সাধারণ ট্রানজ্যাকশনের সময় কমানোর জন্য পে-লোডে কোনও অ্যাকশন নেওয়া হয় না। আমরা ট্রানজ্যাকশনের সময় ব্যবহার করে বাইন্ডার ওভারহেড অনুমান করতে, সবচেয়ে খারাপ কেসের জন্য পরিসংখ্যান তৈরি করতে এবং সেইসব ট্রানজ্যাকশনের অনুপাত গণনা করতে পারি যেগুলির লেটেন্সি নির্দিষ্ট সময়সীমার মধ্যে থাকে।
অগ্রাধিকারের ইনভার্সন ম্যানেজ করা
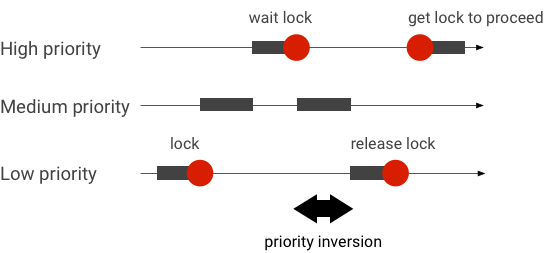
অগ্রাধিকার ইনভার্সন তখনই হয় যখন বেশি অগ্রাধিকারের থ্রেড কম অগ্রাধিকারের থ্রেডের জন্য অপেক্ষা করে। রিয়েল-টাইম (RT) অ্যাপ্লিকেশনে অগ্রাধিকার ইনভার্সন সমস্যা আছে:
Linux Completely Fair Scheduler (CFS) শিডিউলিং ব্যবহার করার সময়, অন্য থ্রেডের অগ্রাধিকার বেশি থাকলেও, একটি থ্রেড সবসময় রান করার সুযোগ পায়। এর ফলে, CFS শিডিউলিং সহ অ্যাপ্লিকেশনগুলি প্রত্যাশিত আচরণ হিসেবে প্রায়োরিটি ইনভার্সন ম্যানেজ করে এবং এটিকে সমস্যা হিসেবে দেখে না। যেসব ক্ষেত্রে Android ফ্রেমওয়ার্ককে RT শিডিউলিং করতে হয় যাতে হাই প্রায়োরিটি থ্রেডের বিশেষ সুবিধা নিশ্চিত করা যায়, সেখানে প্রায়োরিটি ইনভার্সন অবশ্যই সমাধান করতে হবে।
বাইন্ডার ট্রানজ্যাকশনের সময় অগ্রাধিকার ইনভার্সনের উদাহরণ (RT থ্রেডটি লজিক্যালি অন্য CFS থ্রেড দ্বারা ব্লক করা হয় যখন এটি বাইন্ডার থ্রেডের সার্ভিসের জন্য অপেক্ষা করে):
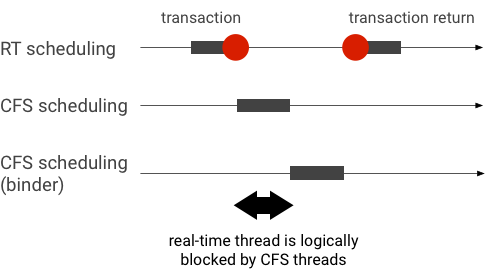
ব্লকেজ এড়াতে, আপনি RT ক্লায়েন্ট থেকে অনুরোধের পরিষেবা দেওয়ার সময় Binder থ্রেডকে সাময়িকভাবে RT থ্রেডে এস্কেলেট করতে অগ্রাধিকার ইনহেরিটেন্স ব্যবহার করতে পারেন। মনে রাখবেন, RT শিডিউলিংয়ের সীমিত রিসোর্স আছে এবং এটি সাবধানে ব্যবহার করা উচিত। n সংখ্যক CPU সহ সিস্টেমে, বর্তমান RT থ্রেডের সর্বাধিক সংখ্যাও হল n; অন্যান্য RT থ্রেড সব CPU ব্যবহার করলে, অতিরিক্ত RT থ্রেডকে অপেক্ষা করতে হতে পারে (এবং এর ফলে সেগুলি ডেডলাইন মিস করতে পারে)।
সম্ভাব্য সব অগ্রাধিকার ইনভার্সন সমাধান করতে, আপনি বাইন্ডার ও hwbinder দুটির জন্যই অগ্রাধিকার ইনহেরিটেন্স ব্যবহার করতে পারেন। তবে, যেহেতু বাইন্ডার সিস্টেম জুড়ে ব্যাপকভাবে ব্যবহৃত হয়, তাই বাইন্ডার ট্রানজ্যাকশনের জন্য অগ্রাধিকার ইনহেরিটেন্স চালু করলে, এটি সিস্টেমকে আরও বেশি RT থ্রেড দিয়ে স্প্যাম করতে পারে যা এটি পরিষেবা দিতে পারে না।
থ্রুপুট টেস্ট রান করা
থ্রুপুট টেস্ট binder/hwbinder ট্রানজ্যাকশন থ্রুপুটের সাথে তুলনা করে চালানো হয়। ওভারলোড হয়নি এমন সিস্টেমে, লেটেন্সি বাবল খুব কমই দেখা যায় এবং ইটারেশনের সংখ্যা যথেষ্ট বেশি হলে সেগুলির প্রভাব দূর করা যায়।
- বাইন্ডার থ্রুপুট টেস্ট
system/libhwbinder/vts/performance/Benchmark_binder.cpp-এ আছে। - hwbinder থ্রুপুট টেস্ট
system/libhwbinder/vts/performance/Benchmark.cpp-এ আছে।
পরীক্ষার ফলাফল
আলাদা আলাদা পে-লোড সাইজ ব্যবহার করে ট্রানজ্যাকশনের জন্য থ্রুপুট টেস্টের ফলাফল সংক্রান্ত উদাহরণ দেওয়া হল:
Benchmark                      Time          CPU           Iterations
---------------------------------------------------------------------
BM_sendVec_binderize/4         70302 ns      32820 ns      21054
BM_sendVec_binderize/8         69974 ns      32700 ns      21296
BM_sendVec_binderize/16        70079 ns      32750 ns      21365
BM_sendVec_binderize/32        69907 ns      32686 ns      21310
BM_sendVec_binderize/64        70338 ns      32810 ns      21398
BM_sendVec_binderize/128       70012 ns      32768 ns      21377
BM_sendVec_binderize/256       69836 ns      32740 ns      21329
BM_sendVec_binderize/512       69986 ns      32830 ns      21296
BM_sendVec_binderize/1024      69714 ns      32757 ns      21319
BM_sendVec_binderize/2k        75002 ns      34520 ns      20305
BM_sendVec_binderize/4k        81955 ns      39116 ns      17895
BM_sendVec_binderize/8k        95316 ns      45710 ns      15350
BM_sendVec_binderize/16k      112751 ns      54417 ns      12679
BM_sendVec_binderize/32k      146642 ns      71339 ns       9901
BM_sendVec_binderize/64k      214796 ns     104665 ns       6495
- সময় রিয়েল টাইমে পরিমাপ করা রাউন্ড ট্রিপের দেরি নির্দেশ করে।
- CPU নির্দেশ করে যে টেস্টের জন্য CPU শিডিউল করা হলে সেটি কতক্ষণ ধরে চলে।
- ইটারেশন থেকে টেস্ট ফাংশন কতবার এক্সিকিউট করা হয়েছে তা জানা যায়।
যেমন, ৮-বাইট পেলোডের জন্য:
BM_sendVec_binderize/8 69974 ns 32700 ns 21296
… বাইন্ডার সর্বাধিক যে থ্রুপুট অর্জন করতে পারে তা এইভাবে গণনা করা হয়:
৮-বাইট পেলোড সহ সর্বাধিক থ্রুপুট = (৮ * ২১২৯৬)/৬৯৯৭৪ ~= ২.৪২৩ b/ns ~= ২.২৬৮ Gb/s
পরীক্ষার বিকল্প
.json ফর্ম্যাটে ফলাফল পেতে, --benchmark_format=json আর্গুমেন্ট সহ পরীক্ষা চালান:
libhwbinder_benchmark --benchmark_format=json
{
  "context": {
    "date": "2017-05-17 08:32:47",
    "num_cpus": 4,
    "mhz_per_cpu": 19,
    "cpu_scaling_enabled": true,
    "library_build_type": "release"
  },
  "benchmarks": [
    {
      "name": "BM_sendVec_binderize/4",
      "iterations": 32342,
      "real_time": 47809,
      "cpu_time": 21906,
      "time_unit": "ns"
    },
   ….
}
লেটেন্সি টেস্ট রান করা
লেটেন্সি টেস্টে ক্লায়েন্টকে ট্রানজ্যাকশন শুরু করতে, সেটি হ্যান্ডেল করার জন্য সার্ভার প্রসেসে সুইচ করতে এবং ফলাফল পেতে কত সময় লাগে তা পরিমাপ করা হয়। এছাড়াও, এই পরীক্ষাটি পরিচিত খারাপ শিডিউলার আচরণগুলিও দেখে যা ট্রানজ্যাকশন লেটেন্সি নেতিবাচকভাবে প্রভাবিত করতে পারে, যেমন এমন একটি শিডিউলার যা অগ্রাধিকার ইনহেরিটেন্স সমর্থন করে না বা সিঙ্ক ফ্ল্যাগকে সম্মান করে না।
- বাইন্ডার লেটেন্সি টেস্ট
frameworks/native/libs/binder/tests/schd-dbg.cpp-এ আছে। - hwbinder লেটেন্সি টেস্ট
system/libhwbinder/vts/performance/Latency.cpp-এ আছে।
পরীক্ষার ফলাফল
ফলাফল (.json-এ) গড়/সেরা/সবচেয়ে খারাপ লেটেন্সি এবং মিস করা ডেডলাইনের সংখ্যা সংক্রান্ত পরিসংখ্যান দেখায়।
পরীক্ষার বিকল্প
লেটেন্সি টেস্টে নিম্নলিখিত বিকল্পগুলি নেওয়া হয়:
| Command | বর্ণনা |
|---|---|
-i value |
ইটারেশনের সংখ্যা নির্দিষ্ট করুন। |
-pair value |
প্রসেস পেয়ারের সংখ্যা নির্দিষ্ট করুন। |
-deadline_us 2500 |
আমাদের কাছে সময়সীমা উল্লেখ করো। |
-v |
ভার্বোস (ডিবাগিং) আউটপুট পান। |
-trace |
ডেডলাইন হিট করার পরে ট্রেস বন্ধ করুন। |
নিম্নলিখিত বিভাগগুলি প্রতিটি বিকল্পের বিবরণ দেয়, ব্যবহার বর্ণনা করে এবং ফলাফলের উদাহরণ প্রদান করে।
ইটেরেশন নির্দিষ্ট করুন
অনেক বেশি ইটারেশন সহ উদাহরণ এবং ভার্বোস আউটপুট বন্ধ করা আছে:
libhwbinder_latency -i 5000 -pair 3
{
"cfg":{"pair":3,"iterations":5000,"deadline_us":2500},
"P0":{"SYNC":"GOOD","S":9352,"I":10000,"R":0.9352,
  "other_ms":{ "avg":0.2 , "wst":2.8 , "bst":0.053, "miss":2, "meetR":0.9996},
  "fifo_ms": { "avg":0.16, "wst":1.5 , "bst":0.067, "miss":0, "meetR":1}
},
"P1":{"SYNC":"GOOD","S":9334,"I":10000,"R":0.9334,
  "other_ms":{ "avg":0.19, "wst":2.9 , "bst":0.055, "miss":2, "meetR":0.9996},
  "fifo_ms": { "avg":0.16, "wst":3.1 , "bst":0.066, "miss":1, "meetR":0.9998}
},
"P2":{"SYNC":"GOOD","S":9369,"I":10000,"R":0.9369,
  "other_ms":{ "avg":0.19, "wst":4.8 , "bst":0.055, "miss":6, "meetR":0.9988},
  "fifo_ms": { "avg":0.15, "wst":1.8 , "bst":0.067, "miss":0, "meetR":1}
},
"inheritance": "PASS"
}
এই টেস্টের ফলাফল নিম্নলিখিত বিষয়গুলি দেখায়:
"pair":3- একটি ক্লায়েন্ট ও সার্ভার পেয়ার তৈরি করে।
"iterations": 5000- এতে ৫০০০ ইটারেশন অন্তর্ভুক্ত।
"deadline_us":2500- সময়সীমা হল ২৫০০us (২.৫ms); বেশিরভাগ ট্রানজ্যাকশন এই মান পূরণ করবে বলে আশা করা হয়।
"I": 10000- একটি টেস্ট আইটারেশনে দুটি (২) ট্রানজ্যাকশন অন্তর্ভুক্ত থাকে:
- সাধারণ অগ্রাধিকার সহ একটি ট্রানজ্যাকশন (
CFS other) - রিয়েল-টাইম অগ্রাধিকারের ভিত্তিতে একটি ট্রানজ্যাকশন (
RT-fifo)
- সাধারণ অগ্রাধিকার সহ একটি ট্রানজ্যাকশন (
"S": 9352- ৯৩৫২টি ট্রানজ্যাকশন একই CPU-তে সিঙ্ক করা হয়েছে।
"R": 0.9352- একই CPU-তে ক্লায়েন্ট ও সার্ভার যে অনুপাতে সিঙ্ক করা হয় তা বোঝায়।
"other_ms":{ "avg":0.2 , "wst":2.8 , "bst":0.053, "miss":2, "meetR":0.9996}- সাধারণ প্রায়োরিটি কলারের ইস্যু করা সব ট্রানজ্যাকশনের ক্ষেত্রে গড় (
avg), সবচেয়ে খারাপ (wst) এবং সবচেয়ে ভালো (bst) কেস। দুটি ট্রানজ্যাকশনmissসময়সীমার মধ্যে সম্পূর্ণ করা হয়েছে, যার ফলে মিট রেশিও (meetR) ০.৯৯৯৬ হয়েছে। "fifo_ms": { "avg":0.16, "wst":1.5 , "bst":0.067, "miss":0, "meetR":1}other_ms-এর মতো, তবে ক্লায়েন্টের ইস্যু করা ট্রানজ্যাকশনের জন্যrt_fifoঅগ্রাধিকার। এটি সম্ভবত (তবে প্রয়োজন নেই) যেfifo_ms-এর ফলাফলother_ms-এর চেয়ে ভালো হবে, যেখানে কমavgওwstভ্যালু এবং বেশিmeetRথাকবে (ব্যাকগ্রাউন্ডে লোড থাকলে পার্থক্য আরও বেশি হতে পারে)।
মনে রাখবেন: ব্যাকগ্রাউন্ড লোড থ্রুপুট ফলাফল এবং লেটেন্সি টেস্টে other_ms টাপলকে প্রভাবিত করতে পারে। ব্যাকগ্রাউন্ড লোডের অগ্রাধিকার RT-fifo-এর থেকে কম হলে,
শুধুমাত্র fifo_ms একই ধরনের ফলাফল দেখাতে পারে।
পেয়ার ভ্যালু নির্দিষ্ট করুন
প্রতিটি ক্লায়েন্ট প্রসেস, ক্লায়েন্টের জন্য নির্দিষ্ট করা সার্ভার প্রসেসের সাথে পেয়ার করা হয়,
এবং প্রতিটি পেয়ার যেকোনও CPU-তে স্বাধীনভাবে শিডিউল করা হতে পারে। তবে, SYNC ফ্ল্যাগ যতক্ষণ
honor থাকবে ততক্ষণ কোনও ট্রানজ্যাকশনের সময় CPU
মাইগ্রেশন হওয়া উচিত নয়।
সিস্টেম ওভারলোড হয়ে যায়নি তো! ওভারলোড হওয়া সিস্টেমে হাই লেটেন্সি প্রত্যাশিত হলেও, ওভারলোড হওয়া সিস্টেমের টেস্ট ফলাফল থেকে কোনও উপযোগী তথ্য পাওয়া যায় না। আরও বেশি প্রেসার সহ সিস্টেম পরীক্ষা করতে, -pair
#cpu-1 ব্যবহার করুন (অথবা -pair #cpu সাবধানে ব্যবহার করুন)। -pair n ব্যবহার করে পরীক্ষা করলে n > #cpu ওভারলোড হয়ে
সিস্টেমের উপর চাপ পড়ে এবং
অপ্রয়োজনীয় তথ্য তৈরি হয়।
ডেডলাইন ভ্যালু নির্দিষ্ট করুন
ব্যবহারকারীর বিভিন্ন পরিস্থিতি নিয়ে বিস্তারিত পরীক্ষা (কোনও উপযুক্ত প্রোডাক্টে লেটেন্সি টেস্ট চালানো) করার পরে, আমরা নির্ধারণ করেছি যে ২.৫ms হল সময়সীমা যা পূরণ করতে হবে। আরও বেশি প্রয়োজনীয়তা (যেমন ১০০০ ফটো/সেকেন্ড) সহ নতুন অ্যাপ্লিকেশনের জন্য, এই ডেডলাইন ভ্যালু পরিবর্তন হবে।
বিস্তারিত আউটপুট নির্দিষ্ট করুন
-v বিকল্প ব্যবহার করলে ভার্বোজ আউটপুট দেখা যায়। উদাহরণ:
libhwbinder_latency -i 1 -v-------------------------------------------------- service pid: 8674 tid: 8674 cpu: 1 SCHED_OTHER 0-------------------------------------------------- main pid: 8673 tid: 8673 cpu: 1 -------------------------------------------------- client pid: 8677 tid: 8677 cpu: 0 SCHED_OTHER 0-------------------------------------------------- fifo-caller pid: 8677 tid: 8678 cpu: 0 SCHED_FIFO 99 -------------------------------------------------- hwbinder pid: 8674 tid: 8676 cpu: 0 ??? 99-------------------------------------------------- other-caller pid: 8677 tid: 8677 cpu: 0 SCHED_OTHER 0 -------------------------------------------------- hwbinder pid: 8674 tid: 8676 cpu: 0 SCHED_OTHER 0
- পরিষেবা থ্রেড একটি
SCHED_OTHERঅগ্রাধিকারের সাথে তৈরি করা হয় এবংpid 8674-এর সাথেCPU:1-এ রান করে। - তারপরে,
fifo-caller-এর মাধ্যমে প্রথম ট্রানজ্যাকশন শুরু করা হয়। এই ট্রানজ্যাকশন পরিষেবা দেওয়ার জন্য, hwbinder সার্ভারের অগ্রাধিকার (pid: 8674 tid: 8676) বাড়িয়ে ৯৯ করে দেয় এবং এটিকে ট্রানজিয়েন্ট শিডিউলিং ক্লাস (???হিসেবে প্রিন্ট করা হয়) দিয়ে চিহ্নিত করে। তারপরে, শিডিউলার সার্ভার প্রসেসকেCPU:0-এ রেখে রান করায় এবং এটিকে ক্লায়েন্টের সাথে একই CPU-তে সিঙ্ক করে। - দ্বিতীয় ট্রানজ্যাকশন কলারের
SCHED_OTHERঅগ্রাধিকার আছে। সার্ভারটি নিজেকে ডাউনগ্রেড করে এবংSCHED_OTHERঅগ্রাধিকার সহ কলারকে পরিষেবা দেয়।
ডিবাগ করার জন্য ট্রেস ব্যবহার করা
লেটেন্সি সংক্রান্ত সমস্যার সমাধান করতে আপনি -trace বিকল্প নির্দিষ্ট করতে পারবেন। ব্যবহার করা হলে, খারাপ
লেটেন্সি শনাক্ত করা হলে লেটেন্সি টেস্ট, ট্রেসলগ রেকর্ডিং বন্ধ করে দেয়।
উদাহরণ:
atrace --async_start -b 8000 -c sched idle workq binder_driver sync freqlibhwbinder_latency -deadline_us 50000 -trace -i 50000 -pair 3deadline triggered: halt ∓ stop trace log:/sys/kernel/debug/tracing/trace
নিম্নলিখিত কম্পোনেন্টগুলি লেটেন্সিকে প্রভাবিত করতে পারে:
- Android বিল্ড মোড। সাধারণত eng মোড userdebug মোডের চেয়ে ধীর গতির হয়।
- ফ্রেমওয়ার্ক। ফ্রেমওয়ার্ক পরিষেবা কীভাবে
ioctlবাইন্ডারের সাথে কনফিগার করার জন্য ব্যবহার করে? - বাইন্ডার ড্রাইভার। ড্রাইভার কি ফাইন-গ্রেনড লকিং সাপোর্ট করে? Does it contain all performance turning patches?
- কার্নেল ভার্সন। কার্নেলের রিয়েল-টাইম ক্ষমতা যত ভালো হবে, ফলাফলও তত ভালো হবে।
- কার্নেল কনফিগারেশন। কার্নেল কনফিগে কি
DEBUGকনফিগ আছে, যেমনDEBUG_PREEMPTএবংDEBUG_SPIN_LOCK? - কার্নেল শিডিউলার। কার্নেলে কি এনার্জি-অ্যাওয়ার
শিডিউলার (EAS) বা হেটেরোজেনিয়াস মাল্টি-প্রসেসিং (HMP) শিডিউলার আছে? কোনও কার্নেল
ড্রাইভার (
cpu-freqড্রাইভার,cpu-idleড্রাইভার,cpu-hotplugইত্যাদি) কি শিডিউলারকে প্রভাবিত করে?