
Android 8.0 شامل آزمایشهای عملکرد binder و hwbinder برای توان عملیاتی و تأخیر است. درحالیکه سناریوهای زیادی برای تشخیص مشکلات عملکردی قابلدرک وجود دارد، اجرای چنین سناریوهایی میتواند زمانبر باشد و نتایج اغلب تا پساز ادغام سیستم دردسترس نیستند. استفاده از آزمونهای عملکرد ارائهشده، آزمایش درطول توسعه، شناسایی مشکلات جدی در مراحل اولیه، و بهبود تجربه کاربری را آسانتر میکند.
آزمایشهای عملکرد شامل چهار دسته زیر است:
- توان گذرداد binder (در
system/libhwbinder/vts/performance/Benchmark_binder.cppدردسترس است) - تأخیر binder (دردسترس در
frameworks/native/libs/binder/tests/schd-dbg.cpp) - توان گذرداد hwbinder (دردسترس در
system/libhwbinder/vts/performance/Benchmark.cpp) - تأخیر hwbinder (در
system/libhwbinder/vts/performance/Latency.cppدردسترس است)
درباره binder و hwbinder
Binder و hwbinder زیرساختهای ارتباط بینفرایندی (IPC) Android هستند که از درایور Linux یکسانی استفاده میکنند اما تفاوتهای کیفی زیر را دارند:
| نسبت ابعادی | binder | hwbinder |
|---|---|---|
| هدف | طرح IPC با هدف کلی برای چارچوب ارائه دهید | ارتباط با سختافزار |
| دارایی | بهینهسازیشده برای استفاده از چارچوب Android | تأخیر کم با حداقل سربار |
| تغییر خطمشی زمانبندی برای پیشزمینه/پسزمینه | بله | نه |
| متغیرهای مستقل درحال عبور | از سریالسازی پشتیبانیشده توسط شیء Parcel استفاده میکند | از بافرهای پراکنده استفاده میکند و از سربار کپی کردن دادههای موردنیاز برای سریالسازی «بسته» اجتناب میکند |
| اولویت ارثی | نه | بله |
پردازشهای Binder و hwbinder
یک تجسمکننده systrace تراکنشها را بهصورت زیر نمایش میدهد:
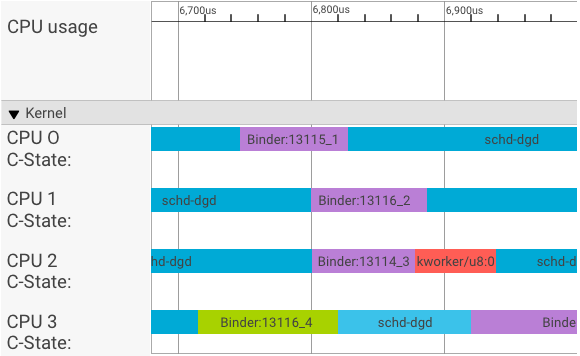
در مثال بالا:
- چهار (۴) فرایند schd-dbg فرایندهای کارخواه هستند.
- چهار (۴) فرایند binder فرایندهای سرور هستند (نام با Binder شروع میشود و با شماره ترتیب بهپایان میرسد).
- فرایند کارخواه همیشه با فرایند سرور جفت میشود که به کارخواه اختصاص داده شده است.
- همه جفتهای فرایند کارخواه-کارساز بهطور مستقل توسط هسته بهطور همزمان زمانبندی میشوند.
در CPU 1، هسته سیستمعامل کارخواه را برای صدور درخواست اجرا میکند. سپس هرگاه ممکن باشد از همان CPU برای بیدار کردن فرایند سرور، رسیدگی به درخواست، و تغییر زمینه پساز تکمیل درخواست استفاده میکند.
گذردهی دربرابر تأخیر
در تراکنش بینقص، که در آن پردازش کارخواه و کارساز بهطور یکپارچه جابهجا میشود، آزمایشهای گذردهی و تأخیر پیامهای بسیار متفاوتی تولید نمیکنند. بااینحال، وقتی هسته سیستمعامل درحال رسیدگی به درخواست وقفه (IRQ) از سختافزار، منتظر قفلها، یا صرفاً انتخاب عدم رسیدگی فوری به پیام است، حباب تأخیر میتواند شکل بگیرد.

آزمون گذردهی تعداد زیادی تراکنش با اندازههای مختلف بار تولید میکند و تخمین خوبی از زمان تراکنش معمولی (در بهترین حالت) و حداکثر گذردهی که پیونددهنده میتواند به آن دست یابد ارائه میدهد.
درمقابل، آزمایش تأخیر هیچ کنشی روی بار مفید انجام نمیدهد تا زمان تراکنش معمولی را به حداقل برساند. میتوانیم از زمان تراکنش برای تخمین سربار binder، تهیه آمار برای بدترین حالت، و محاسبه نسبت تراکنشهایی که تأخیر آنها با مهلت مشخصشده مطابقت دارد استفاده کنیم.
مدیریت وارونگی اولویت
وارونگی اولویت زمانی رخ میدهد که یک رشته با اولویت بالاتر بهطور منطقی منتظر رشتهای با اولویت پایینتر باشد. برنامههای همزمان (RT) مشکل وارونگی اولویت دارند:
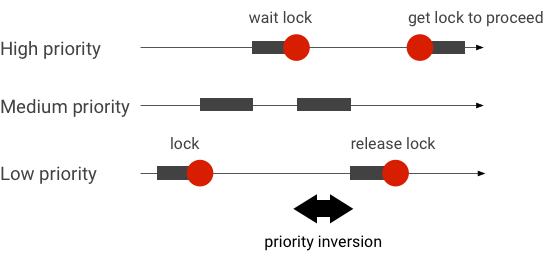
هنگام استفاده از زمانبندی «برنامهریز کاملاً منصفانه» (CFS) در Linux، رشته همیشه فرصتی برای اجرا دارد، حتی اگر رشتههای دیگر اولویت بالاتری داشته باشند. درنتیجه، برنامههایی که زمانبندی CFS دارند، وارونگی اولویت را بهعنوان رفتار موردانتظار و نه بهعنوان مشکل مدیریت میکنند. اما در مواردی که چارچوب Android برای تضمین امتیاز رشتههای با اولویت بالا به زمانبندی RT نیاز دارد، وارونگی اولویت باید حل شود.
نمونهای از وارونگی اولویت درطول تراکنش binder (رشته RT بهطور منطقی توسط رشتههای CFS دیگر مسدود شده است، زیرا منتظر است رشته binder سرویس ارائه دهد):
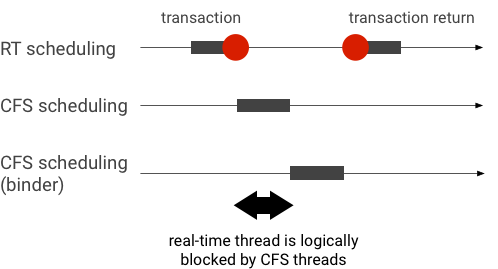
برای جلوگیری از مسدود شدن، میتوانید از ارثبری اولویت برای موقتاً ارتقا دادن رشته Binder به رشته RT هنگام ارائه خدمات به درخواست مشتری RT استفاده کنید. بهخاطر داشته باشید که زمانبندی RT منابع محدودی دارد و باید با دقت استفاده شود. در سیستمی با n واحد پردازش مرکزی، حداکثر تعداد رشتههای RT جاری نیز n است؛ اگر همه واحدهای پردازش مرکزی توسط رشتههای RT دیگر اشغال شده باشند، رشتههای RT اضافی ممکن است نیاز به انتظار داشته باشند (و درنتیجه مهلتهای خود را ازدست بدهند).
برای حل کردن همه وارونگیهای اولویت ممکن، میتوانید از اولویت وراثت برای هر دو binder و hwbinder استفاده کنید. بااینحال، ازآنجاییکه از binder بهطور گسترده در سراسر سیستم استفاده میشود، فعال کردن ارثبری اولویت برای تراکنشهای binder ممکن است سیستم را با رشتههای RT بیشتری نسبتبه آنچه میتواند سرویسدهی کند، هرزفرستی کند.
اجرای آزمایشهای توان عملیاتی
آزمایش توان عملیاتی دربرابر توان عملیاتی تراکنش binder/hwbinder اجرا میشود. در سیستمی که بار اضافی ندارد، حبابهای تأخیر نادر هستند و تا زمانی که تعداد تکرارها به اندازه کافی زیاد باشد، تأثیر آنها میتواند ازبین برود.
- آزمایش گذردهی پیونددهنده در
system/libhwbinder/vts/performance/Benchmark_binder.cppاست. - آزمایش توان گذرداد hwbinder در
system/libhwbinder/vts/performance/Benchmark.cppاست.
نتایج آزمایش
نمونه نتایج آزمایش توان عملیاتی برای تراکنشهایی که از اندازههای مختلف بار مفید استفاده میکنند:
Benchmark                      Time          CPU           Iterations
---------------------------------------------------------------------
BM_sendVec_binderize/4         70302 ns      32820 ns      21054
BM_sendVec_binderize/8         69974 ns      32700 ns      21296
BM_sendVec_binderize/16        70079 ns      32750 ns      21365
BM_sendVec_binderize/32        69907 ns      32686 ns      21310
BM_sendVec_binderize/64        70338 ns      32810 ns      21398
BM_sendVec_binderize/128       70012 ns      32768 ns      21377
BM_sendVec_binderize/256       69836 ns      32740 ns      21329
BM_sendVec_binderize/512       69986 ns      32830 ns      21296
BM_sendVec_binderize/1024      69714 ns      32757 ns      21319
BM_sendVec_binderize/2k        75002 ns      34520 ns      20305
BM_sendVec_binderize/4k        81955 ns      39116 ns      17895
BM_sendVec_binderize/8k        95316 ns      45710 ns      15350
BM_sendVec_binderize/16k      112751 ns      54417 ns      12679
BM_sendVec_binderize/32k      146642 ns      71339 ns       9901
BM_sendVec_binderize/64k      214796 ns     104665 ns       6495
- زمان نشاندهنده تأخیر رفتوبرگشت است که بهصورت همزمان اندازهگیری میشود.
- CPU نشاندهنده زمان انباشتهشدهای است که CPUها برای آزمایش زمانبندی میشوند.
- تکرارها نشاندهنده تعداد دفعاتی است که تابع آزمایش اجرا شده است.
برای مثال، برای یک بار ۸ بایتی:
BM_sendVec_binderize/8 69974 ns 32700 ns 21296
… حداکثر توان عملیاتی که چسباننده میتواند به آن دست یابد به این صورت محاسبه میشود:
حداکثر توان عملیاتی با بار مفید ۸ بایتی = (۸ * ۲۱۲۹۶)/۶۹۹۷۴ ~= ۲٫۴۲۳ بیت/نانوثانیه ~= ۲٫۲۶۸ گیگابیت/ثانیه
گزینههای آزمایش
برای دریافت نتایج در قالب .json، آزمون را با
--benchmark_format=json آرگومان اجرا کنید:
libhwbinder_benchmark --benchmark_format=json
{
  "context": {
    "date": "2017-05-17 08:32:47",
    "num_cpus": 4,
    "mhz_per_cpu": 19,
    "cpu_scaling_enabled": true,
    "library_build_type": "release"
  },
  "benchmarks": [
    {
      "name": "BM_sendVec_binderize/4",
      "iterations": 32342,
      "real_time": 47809,
      "cpu_time": 21906,
      "time_unit": "ns"
    },
   ….
}
اجرای آزمایشهای تأخیر
آزمایش تأخیر زمانی را که طول میکشد تا کارخواه شروع به مقداردهی اولیه تراکنش کند، به فرایند سرور برای مدیریت تغییر کند، و نتیجه را دریافت کند اندازهگیری میکند. این آزمایش همچنین بهدنبال رفتارهای زمانبندی بد شناختهشدهای است که میتواند بر تأخیر تراکنش تأثیر منفی بگذارد، مانند زمانبندیای که از ارثبری اولویت پشتیبانی نمیکند یا پرچم همگامسازی را رعایت نمیکند.
- آزمایش تأخیر اتصالدهنده در
frameworks/native/libs/binder/tests/schd-dbg.cppاست. - آزمایش تأخیر hwbinder در
system/libhwbinder/vts/performance/Latency.cppانجام میشود.
نتایج آزمایش
نتایج (در قالب json.) آمار مربوط به میانگین/بهترین/بدترین تأخیر و تعداد مهلتهای ازدسترفته را نشان میدهد.
گزینههای آزمون
آزمایشهای تأخیر گزینههای زیر را میگیرند:
| فرمان | شرح |
|---|---|
-i value |
تعداد تکرارها را مشخص کنید. |
-pair value |
تعداد جفتهای فرایند را مشخص کنید. |
-deadline_us 2500 |
مهلت را به ما اعلام کنید. |
-v |
برونداد مفصل (اشکالزدایی) دریافت کنید. |
-trace |
وقتی به مهلت مقرر رسیدید، ردیابی را متوقف کنید. |
بخشهای زیر هر گزینه را بهتفصیل شرح میدهند، نحوه استفاده را توضیح میدهند، و نتایج نمونه ارائه میدهند.
تعداد تکرارها را مشخص کنید
مثال با تعداد زیادی تکرار و برونداد پرحرف غیرفعال:
libhwbinder_latency -i 5000 -pair 3
{
"cfg":{"pair":3,"iterations":5000,"deadline_us":2500},
"P0":{"SYNC":"GOOD","S":9352,"I":10000,"R":0.9352,
  "other_ms":{ "avg":0.2 , "wst":2.8 , "bst":0.053, "miss":2, "meetR":0.9996},
  "fifo_ms": { "avg":0.16, "wst":1.5 , "bst":0.067, "miss":0, "meetR":1}
},
"P1":{"SYNC":"GOOD","S":9334,"I":10000,"R":0.9334,
  "other_ms":{ "avg":0.19, "wst":2.9 , "bst":0.055, "miss":2, "meetR":0.9996},
  "fifo_ms": { "avg":0.16, "wst":3.1 , "bst":0.066, "miss":1, "meetR":0.9998}
},
"P2":{"SYNC":"GOOD","S":9369,"I":10000,"R":0.9369,
  "other_ms":{ "avg":0.19, "wst":4.8 , "bst":0.055, "miss":6, "meetR":0.9988},
  "fifo_ms": { "avg":0.15, "wst":1.8 , "bst":0.067, "miss":0, "meetR":1}
},
"inheritance": "PASS"
}
این نتایج آزمایش موارد زیر را نشان میدهد:
"pair":3- یک جفت کارخواه و سرور ایجاد میکند.
"iterations": 5000- شامل ۵۰۰۰ تکرار است.
"deadline_us":2500- مهلت ۲۵۰۰ میکروثانیه (۲٫۵ میلیثانیه) است؛ انتظار میرود اکثر تراکنشها این مقدار را برآورده کنند.
"I": 10000- یک تکرار آزمایش شامل دو (۲) تراکنش است:
- یک تراکنش با اولویت معمولی (
CFS other) - یک تراکنش با اولویت همزمان (
RT-fifo)
- یک تراکنش با اولویت معمولی (
"S": 9352
- ۹۳۵۲ تراکنش در همان CPU همگامسازی شده است.
"R": 0.9352- نسبتی را نشان میدهد که براساس آن کارخواه و سرور در همان CPU با هم همگامسازی میشوند.
"other_ms":{ "avg":0.2 , "wst":2.8 , "bst":0.053, "miss":2, "meetR":0.9996}- میانگین (
avg)، بدترین (wst)، و بهترین (bst) حالت برای همه تراکنشهای صادرشده توسط تماسگیرنده با اولویت عادی. دو تراکنشmissسررسید انجام شد و نسبت ملاقات (meetR) به ۰٫۹۹۹۶ رسید. "fifo_ms": { "avg":0.16, "wst":1.5 , "bst":0.067, "miss":0, "meetR":1}- مشابه
other_ms، اما برای تراکنشهای صادرشده توسط مشتری باrt_fifoاولویت. احتمالاً (اما نه لزوماً)fifo_msنتیجه بهتری نسبتبهother_msدارد، با مقادیرavgوwstکمتر وmeetRبالاتر (این تفاوت میتواند با بارگذاری در پسزمینه حتی قابلتوجهتر باشد).
توجه: بار پسزمینه ممکن است بر نتیجه
گذردهی و other_ms تاپل در آزمون تأخیر تأثیر بگذارد. فقط
fifo_ms ممکن است نتایج مشابهی را نشان دهد، بهشرطی که بار پسزمینه
اولویت کمتری نسبتبه RT-fifo داشته باشد.
مشخص کردن مقادیر جفت
هر فرایند مشتری با فرایند سروری که به مشتری اختصاص داده شده است جفت میشود،
و هر جفت میتواند بهطور مستقل برای هر واحد پردازش مرکزی زمانبندی شود. بااینحال، تا زمانی که پرچم SYNC روی
honor تنظیم شده باشد، انتقال CPU نباید درطول تراکنش انجام شود.
مطمئن شوید سیستم دچار بار اضافی نشده باشد! اگرچه تأخیر بالا در سیستم بیشازحد بارگذاریشده
قابلانتظار است، نتایج آزمایش برای سیستم بیشازحد بارگذاریشده اطلاعات مفیدی ارائه نمیدهد. برای آزمایش سیستم با فشار بالاتر، از -pair
#cpu-1 (یا -pair #cpu با احتیاط) استفاده کنید. آزمایش بااستفاده از
-pair n با n > #cpu سیستم را
بیشازحد بار میکند و اطلاعات بیفایده تولید میکند.
مقادیر مهلت را مشخص کنید
پساز آزمایشهای گسترده سناریو کاربر (اجرای آزمایش تأخیر در محصول واجدشرایط)، تعیین کردیم که مهلت رسیدن به این هدف ۲٫۵ میلیثانیه است. برای درخواستهای جدید با الزامات بالاتر (مثل ۱۰۰۰ عکس در ثانیه)، این مقدار مهلت تغییر خواهد کرد.
برونداد مفصل را مشخص کنید
استفاده از گزینه -v برونداد پرحرف را نمایش میدهد. مثال:
libhwbinder_latency -i 1 -v-------------------------------------------------- service pid: 8674 tid: 8674 cpu: 1 SCHED_OTHER 0-------------------------------------------------- main pid: 8673 tid: 8673 cpu: 1 -------------------------------------------------- client pid: 8677 tid: 8677 cpu: 0 SCHED_OTHER 0-------------------------------------------------- fifo-caller pid: 8677 tid: 8678 cpu: 0 SCHED_FIFO 99 -------------------------------------------------- hwbinder pid: 8674 tid: 8676 cpu: 0 ??? 99-------------------------------------------------- other-caller pid: 8677 tid: 8677 cpu: 0 SCHED_OTHER 0 -------------------------------------------------- hwbinder pid: 8674 tid: 8676 cpu: 0 SCHED_OTHER 0
- رشته سرویس با اولویت
SCHED_OTHERایجاد میشود و درCPU:1باpid 8674اجرا میشود. - سپس اولین تراکنش توسط
fifo-callerشروع میشود. برای ارائه این تراکنش، hwbinder اولویت سرور (pid: 8674 tid: 8676) را به ۹۹ ارتقا میدهد و همچنین آن را با کلاس زمانبندی گذرا (که بهصورت???چاپ میشود) علامتگذاری میکند. سپس زمانبند فرایند سرور را درCPU:0قرار میدهد تا اجرا شود و آن را با همان CPU با کارخواه خود همگامسازی میکند. - تماسگیرنده تراکنش دوم اولویت
SCHED_OTHERدارد. سرور خود را تنزل میدهد و به تماسگیرنده با اولویتSCHED_OTHERخدمات ارائه میدهد.
استفاده از ردیابی برای اشکالزدایی
میتوانید گزینه -trace را برای اشکالزدایی مشکلات تأخیر مشخص کنید. وقتی
استفاده میشود، آزمایش تأخیر ضبط tracelog را در لحظهای که تأخیر بد
تشخیص داده میشود متوقف میکند. مثال:
atrace --async_start -b 8000 -c sched idle workq binder_driver sync freqlibhwbinder_latency -deadline_us 50000 -trace -i 50000 -pair 3deadline triggered: halt ∓ stop trace log:/sys/kernel/debug/tracing/trace
مؤلفههای زیر میتوانند بر تأخیر تأثیر بگذارند:
- حالت ساخت Android. حالت مهندسی معمولاً کندتر از حالت userdebug است.
- Framework. سرویس چارچوب چگونه از
ioctlبرای پیکربندی با پیونددهنده استفاده میکند؟ - درایور Binder. آیا درایور از قفل کردن ریزدانه پشتیبانی میکند؟ آیا شامل همه وصلههای بهبود عملکرد است؟
- نسخه اصلی. هرچه قابلیت زمان واقعی هسته بهتر باشد، نتایج بهتر خواهد بود.
- پیکربندی هسته. آیا پیکربندی هسته حاوی
پیکربندیهای
DEBUGمثلDEBUG_PREEMPTوDEBUG_SPIN_LOCKاست؟ - زمانبند هسته. آیا هسته دارای زمانبند «آگاه از انرژی» (EAS) یا زمانبند «پردازش چندگانه ناهمگن» (HMP) است؟ آیا درایورهای هسته (درایور
cpu-freq، درایورcpu-idle،cpu-hotplug، و غیره) بر زمانبند تأثیر میگذارند؟